
Prometheus et Grafana
Vue d’ensemble
Section intitulée « Vue d’ensemble »OKStatus expose l’état de tous les monitors de votre organisation au format Prometheus, sur une seule URL :
https://api.okstatus.eu/api/v1/metricsPointez votre Prometheus (ou Grafana Alloy, VictoriaMetrics, Grafana Cloud…) dessus et OKStatus devient une source de plus dans la stack que vous utilisez déjà : la vue externe de vos services, à côté de vos métriques internes.
Disponible à partir du plan Pro.
Créer une clé Métriques
Section intitulée « Créer une clé Métriques »- Allez dans Paramètres → Clés API.
- En Pro, le type de clé est Métriques. En Max et Enterprise, choisissez Métriques sous Accès (présélectionné quand le nom contient « prometheus » ou « grafana »).
- Nommez la clé, puis cliquez sur Générer une clé Prometheus.
- Copiez la clé : elle n’est affichée qu’une fois.
Une clé Métriques lit /api/v1/metrics, rien d’autre. Si elle fuite d’un
fichier de configuration ou d’un dépôt Git, elle ne peut ni lire le reste de
l’API, ni modifier ou supprimer quoi que ce soit. Voir Clés API et niveaux
d’accès.
Configurer Prometheus
Section intitulée « Configurer Prometheus »Enregistrez la clé dans un fichier lisible par Prometheus, jamais dans
prometheus.yml lui-même :
umask 077printf '%s' 'oks_live_…' > /etc/prometheus/okstatus.tokenPuis ajoutez la cible :
scrape_configs: - job_name: okstatus scrape_interval: 30s scheme: https metrics_path: /api/v1/metrics authorization: credentials_file: /etc/prometheus/okstatus.token static_configs: - targets: [api.okstatus.eu]Grafana Alloy :
prometheus.scrape "okstatus" { targets = [{ "__address__" = "api.okstatus.eu" }] scheme = "https" metrics_path = "/api/v1/metrics" scrape_interval = "30s" authorization { credentials_file = "/etc/alloy/okstatus.token" } forward_to = [prometheus.remote_write.default.receiver]}Prometheus Operator (kube-prometheus-stack) : rangez la clé dans un Secret, puis :
apiVersion: monitoring.coreos.com/v1alpha1kind: ScrapeConfigmetadata: name: okstatusspec: scheme: HTTPS metricsPath: /api/v1/metrics scrapeInterval: 30s authorization: type: Bearer credentials: name: okstatus-token # Secret with the key under "token" key: token staticConfigs: - targets: [api.okstatus.eu]Vérifiez la clé depuis un terminal :
curl -s -H "Authorization: Bearer $(cat /etc/prometheus/okstatus.token)" \ https://api.okstatus.eu/api/v1/metrics | grep okstatus_monitor_upIntervalle et limites
Section intitulée « Intervalle et limites »- La réponse est calculée une fois et mise en cache 15 secondes par organisation : scraper plus souvent que toutes les 15 s renvoie les mêmes chiffres. 30 s ou 60 s est un bon intervalle.
- Chaque organisation peut scraper 60 fois par minute, dans un budget
séparé du reste de l’API (vos
terraform planet vos scripts ne sont pas en concurrence avec Prometheus). Deux Prometheus en haute disponibilité passent sans problème. - Les réponses sont compressées en gzip quand Prometheus le demande (il le fait toujours).
Dashboard Grafana
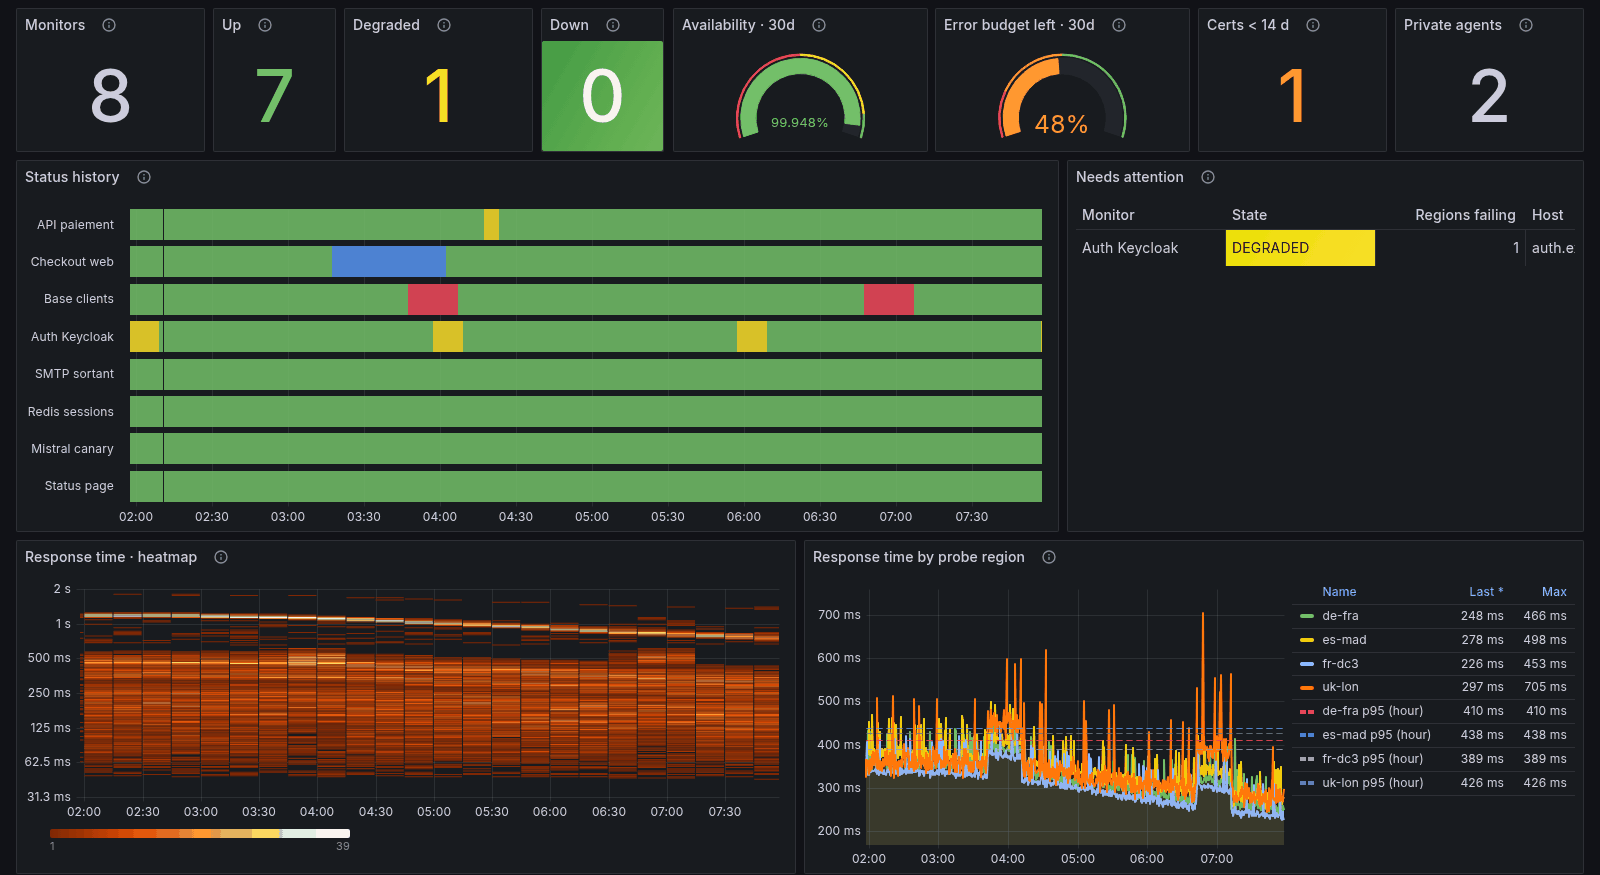
Section intitulée « Dashboard Grafana »Le dashboard OKStatus · Uptime overview n’utilise que ces métriques :
- monitors up, dégradés et down, disponibilité moyenne et budget d’erreur restant par rapport à votre objectif SLA ;
- l’historique d’état de chaque monitor ;
- une heatmap des temps de réponse et les temps de réponse par région de sonde ;
- le dernier check de chaque monitor depuis chaque région de sonde ;
- la disponibilité de chaque monitor face à l’objectif SLA ;
- un tableau de tous les monitors : état, latence, disponibilité sur 24 h, 7 jours et 30 jours, jours avant l’expiration du certificat ;
- les prochaines expirations de certificats et de domaines ;
- vos agents privés : vivacité, version et charge ;
- des rangées repliées pour les monitors de modèles d’IA (temps avant le premier token) et le détail SLA par monitor.
Filtres en haut : groupe de monitors, monitor, région de sonde et fenêtre SLA.
L’importer : dans Grafana, Dashboards → New → Import, saisissez l’ID 25909 et cliquez sur Load, puis choisissez votre source de données Prometheus. Le dashboard est publié sur grafana.com ; si votre Grafana n’a pas accès à internet, chargez plutôt okstatus-uptime-overview.json. Sa source, avec les règles d’alerte, est sur GitHub.
Règles d’alerte
Section intitulée « Règles d’alerte »okstatus-alerts.yml contient dix règles Prometheus prêtes à l’emploi :
| Alerte | Quand |
|---|---|
OKStatusMonitorDown | un monitor est down (majorité de ses régions de sonde) |
OKStatusMonitorDegraded | dégradé depuis 10 minutes |
OKStatusProbeRegionDown | une région de sonde échoue depuis 15 minutes sans que le monitor soit down |
OKStatusCertificateExpiresSoon | un certificat TLS expire sous 14 jours (critique sous 3 jours) |
OKStatusDomainExpiresSoon | un domaine expire sous 30 jours |
OKStatusSlaTargetMissed | disponibilité sur 30 jours sous l’objectif SLA du monitor, ou celui de l’organisation |
OKStatusMonitorStale | aucun check depuis trois intervalles, hors pause et maintenance |
OKStatusPrivateAgentDown | un agent privé n’envoie plus de signal de vie |
OKStatusExportUnreachable | Prometheus ne peut plus scraper l’export (clé révoquée ou expirée, plan, réseau) |
Chargez le fichier avec rule_files: dans prometheus.yml, ou placez ses
groups: dans une PrometheusRule pour le Prometheus Operator. Dans
OKStatusExportUnreachable, remplacez job par le nom de votre job de
scrape.
Référence des métriques
Section intitulée « Référence des métriques »Chaque série d’un monitor porte monitor_id, monitor_name,
monitor_type, monitor_host et, si le monitor est dans un groupe,
monitor_group. monitor_host ne contient que l’hôte (et le port) : jamais
le schéma, le chemin, la query string ni les identifiants, qui peuvent
contenir des secrets.
| Métrique | Labels | Signification |
|---|---|---|
okstatus_monitor_up | 1 up ou dégradé, 0 down. Absente en pause, en maintenance, en attente ou sans données récentes | |
okstatus_monitor_status | state | une série par état (up, degraded, down, paused, maintenance, pending, stale), 1 pour l’état courant |
okstatus_monitor_info | regions | toujours 1, porte les métadonnées du monitor |
okstatus_monitor_check_interval_seconds | intervalle de check configuré | |
okstatus_region_up | probe_region | dernier check depuis cette région : 1 up ou dégradé, 0 down |
okstatus_check_latency_seconds | probe_region | temps de réponse du dernier check |
okstatus_check_status_code | probe_region | code HTTP du dernier check |
okstatus_check_timestamp_seconds | probe_region | heure du dernier check |
okstatus_check_latency_hourly_seconds | probe_region, percentile | p50, p95, p99 du dernier agrégat horaire (tous les checks, pas seulement les échantillons scrapés) |
okstatus_monitor_availability_ratio | window | disponibilité sur 24h, 7d, 30d, de 0 à 1 : le chiffre du dashboard et des rapports SLA |
okstatus_monitor_downtime_seconds | window | temps passé down sur la fenêtre |
okstatus_monitor_sla_target_ratio | objectif SLA du monitor, de 0 à 1 | |
okstatus_org_sla_target_ratio | objectif SLA de l’organisation, de 0 à 1 | |
okstatus_certificate_expiry_timestamp_seconds | expiration du certificat TLS (précision au jour) | |
okstatus_domain_expiry_timestamp_seconds | domain | expiration de l’enregistrement du domaine |
okstatus_push_last_received_timestamp_seconds | monitors heartbeat : dernier ping reçu | |
okstatus_llm_time_to_first_token_seconds | probe_region | monitors de modèles d’IA : temps avant le premier token |
okstatus_llm_time_per_output_token_seconds | probe_region | monitors de modèles d’IA : temps par token produit |
okstatus_private_agent_up | agent_id, agent_name | 1 si un signal de vie est arrivé dans les 90 dernières secondes |
okstatus_private_agent_info | site, version, platform | toujours 1 |
okstatus_private_agent_last_heartbeat_timestamp_seconds | agent_id, agent_name | dernier signal de vie |
okstatus_private_agent_active_checks | agent_id, agent_name | checks en cours en ce moment |
okstatus_private_agent_max_concurrent_checks | agent_id, agent_name | plafond de parallélisme de l’agent |
okstatus_exporter_generated_timestamp_seconds | heure de calcul de cette réponse | |
okstatus_exporter_info | version | version de l’exporter, toujours 1 |
Les unités suivent les conventions Prometheus : secondes, ratios de 0 à 1,
timestamps Unix. La région de sonde s’appelle probe_region et non region,
que beaucoup d’installations Prometheus utilisent déjà comme label externe.
Requêtes utiles
Section intitulée « Requêtes utiles »# Jours avant l'expiration de chaque certificat(okstatus_certificate_expiry_timestamp_seconds - time()) / 86400
# Monitors down en ce momentokstatus_monitor_up == 0
# Temps de réponse moyen par région de sondeavg by (probe_region) (okstatus_check_latency_seconds)
# Vu down de l'extérieur alors que votre sonde blackbox le voit up :# un problème de DNS, de CDN ou de routage, pas du service lui-mêmeokstatus_monitor_up == 0 and on (monitor_host) label_replace(probe_success == 1, "monitor_host", "$1", "instance", "https?://([^/]+).*")| Statut | Signification |
|---|---|
401 | clé absente, invalide, révoquée ou expirée |
403 | le plan de l’organisation n’inclut pas l’export, ou l’accès de la clé ne le permet pas |
429 | plus de 60 scrapes par minute : ce scrape échoue, l’intervalle suivant passe |