Modèle IA
Présentation
Section intitulée « Présentation »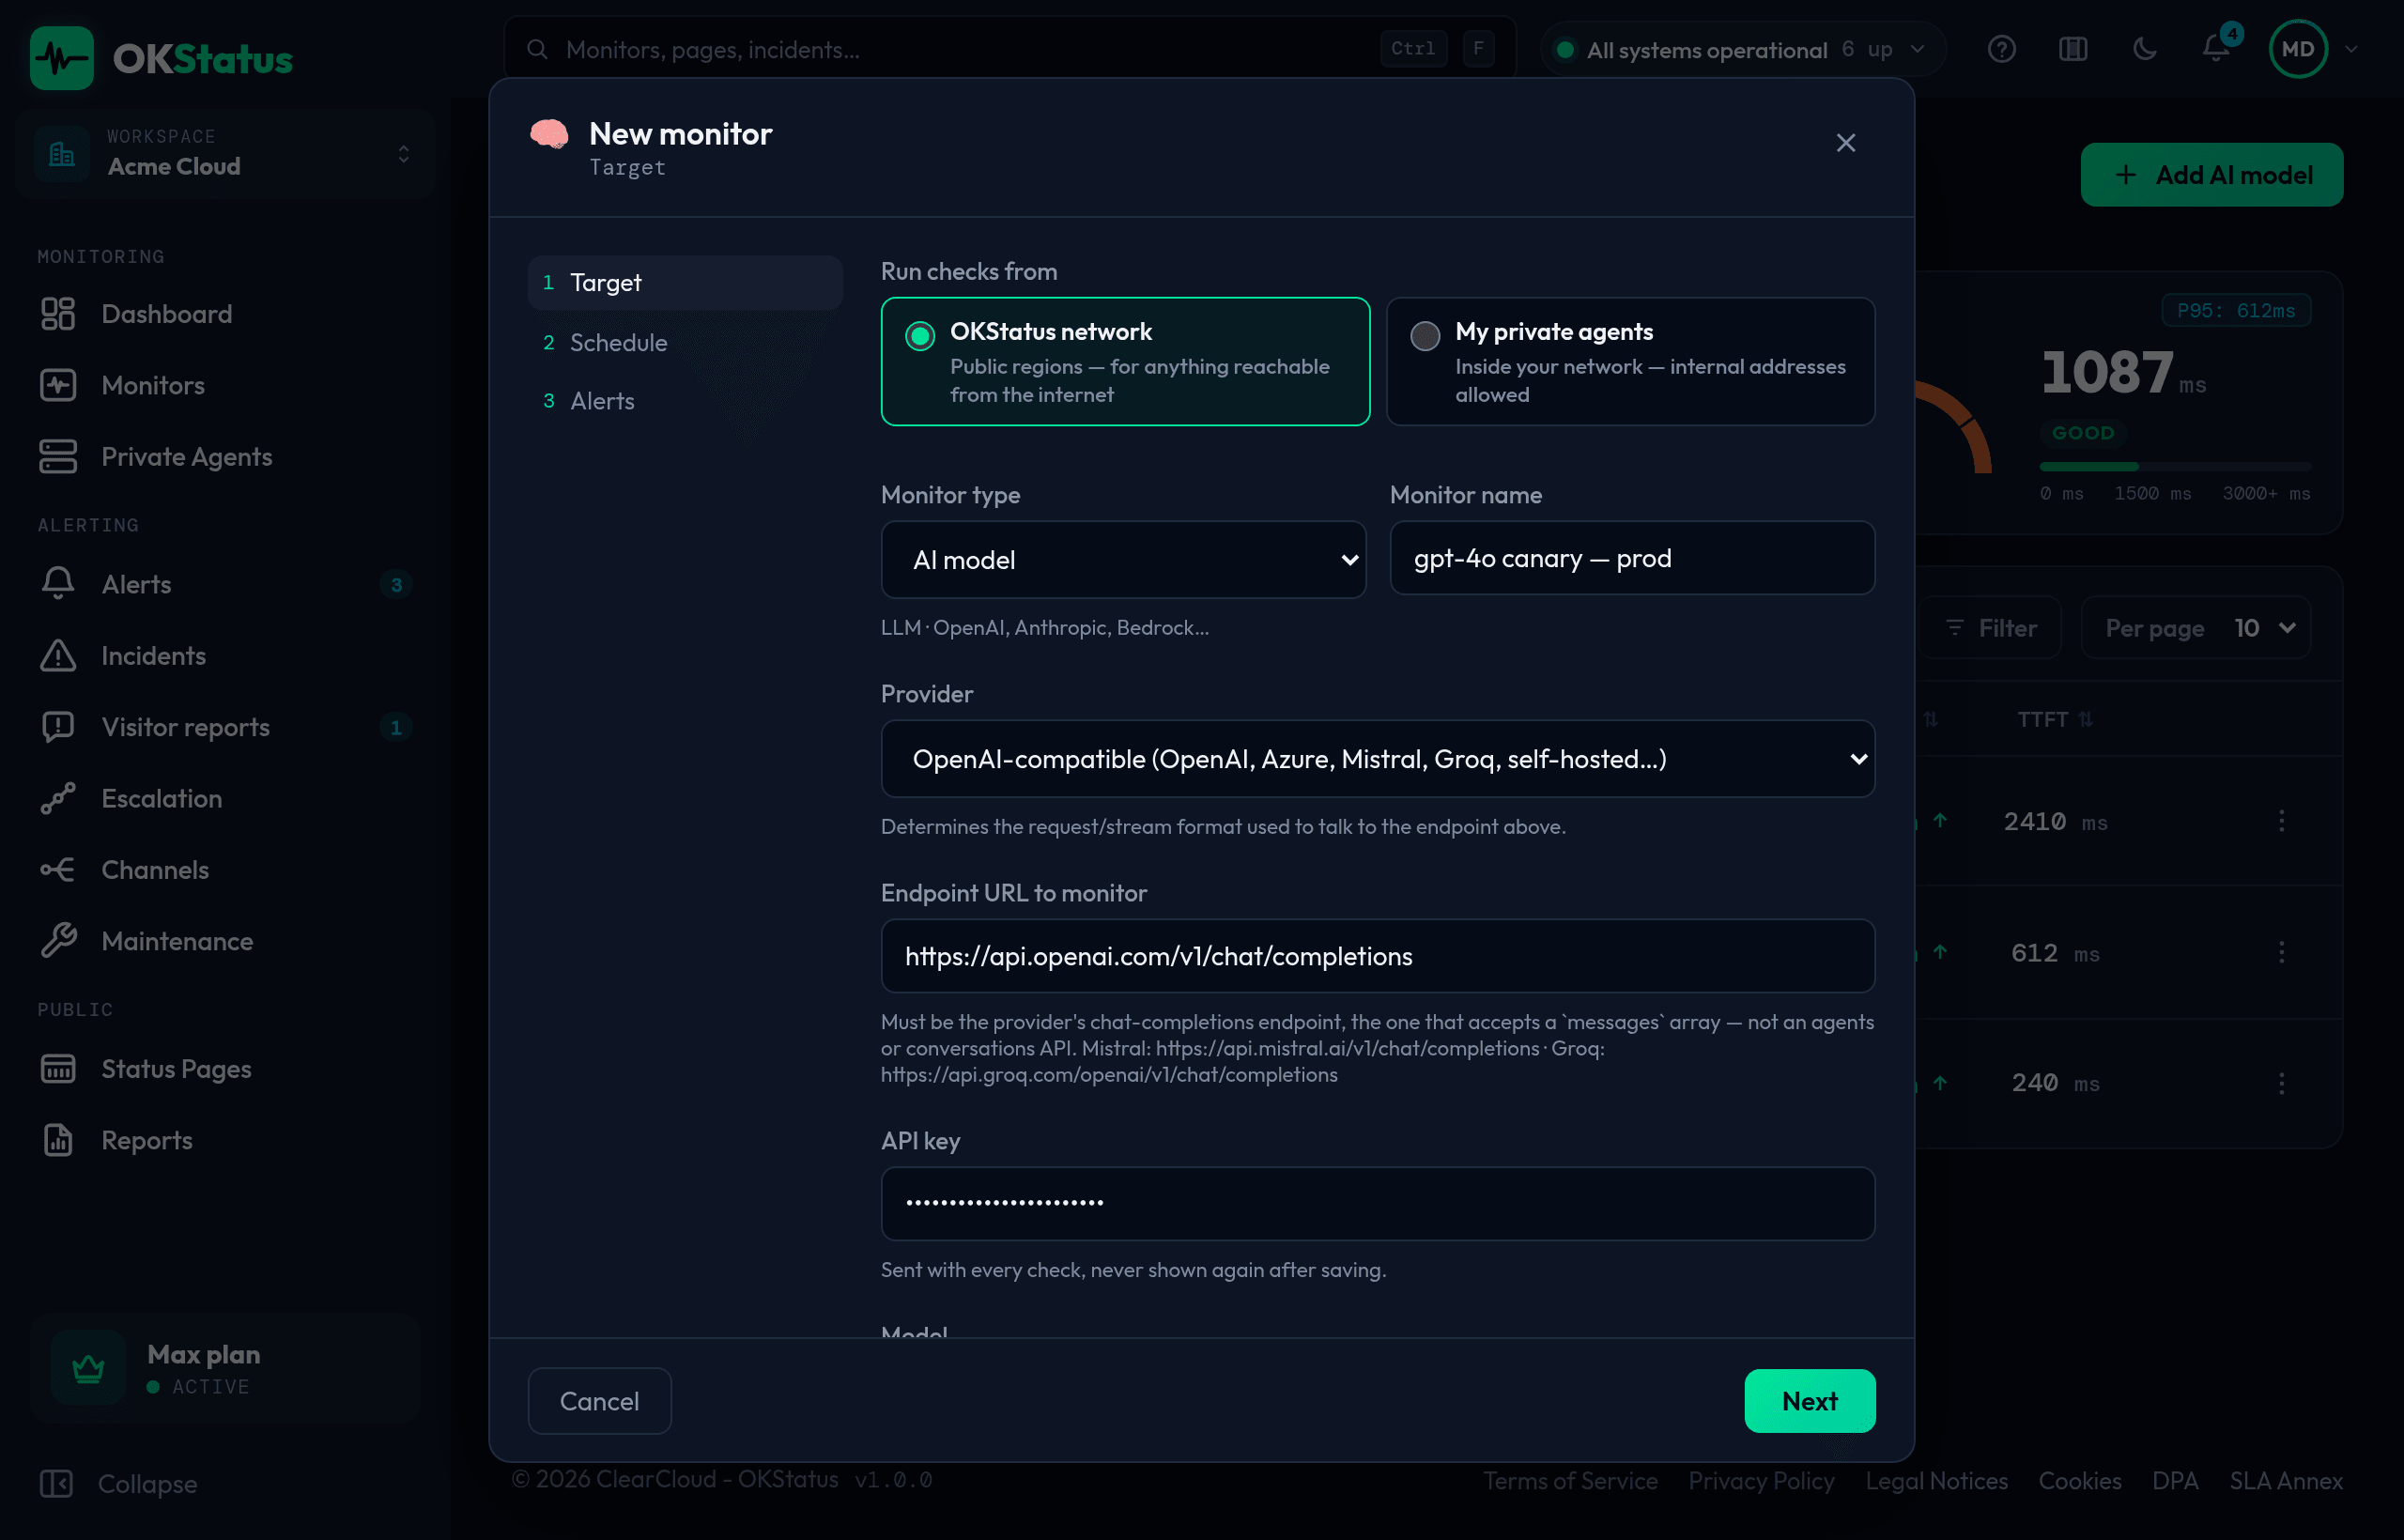
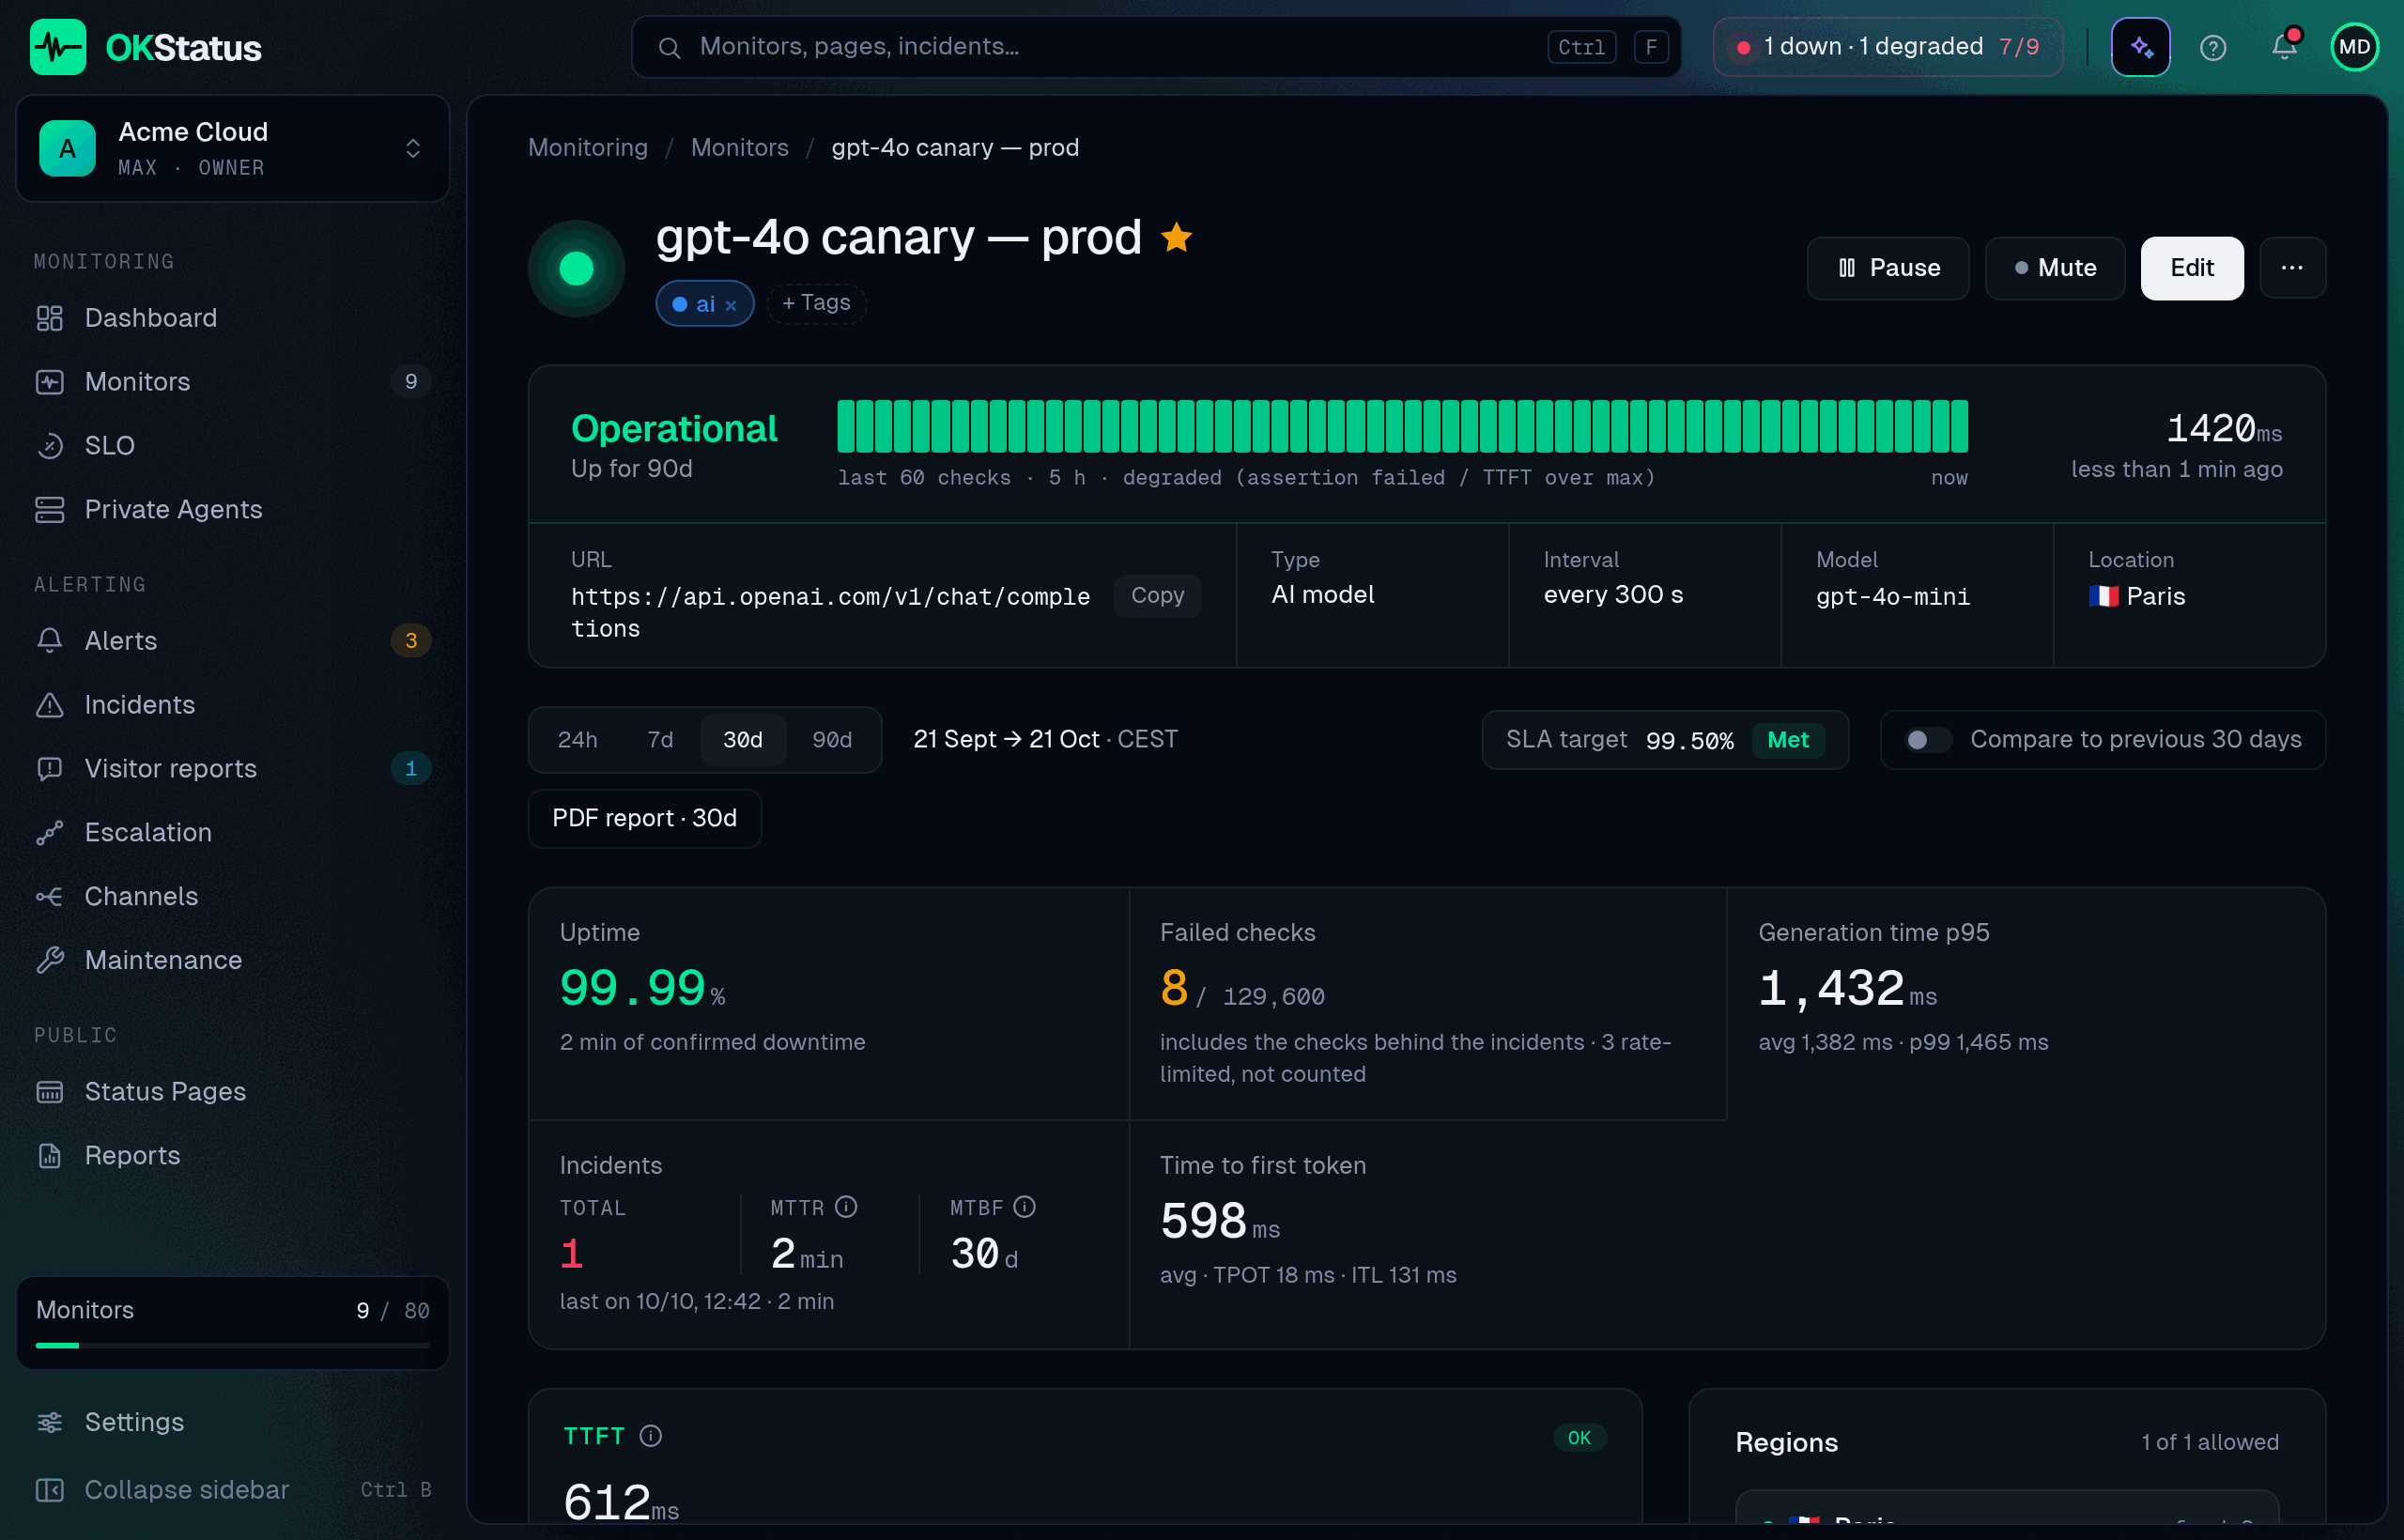
Le monitor de modèle IA (un canari LLM) envoie un prompt fixe à l’endpoint de complétion de chat d’un fournisseur LLM selon un intervalle donné, et vérifie qu’il répond — et qu’il répond correctement — dans un délai acceptable. Conçu pour les équipes qui font tourner des fonctionnalités de production sur une API LLM et qui doivent savoir dès que cette dépendance se dégrade, pas seulement quand elle tombe complètement.
Il se crée depuis Monitors → Ajouter un monitor, en choisissant Modèle IA dans la liste des types : la fenêtre demande alors le fournisseur, l’endpoint, la clé d’API et le modèle à la place des options HTTP. Dans la liste Monitors, un modèle IA affiche le logo de son fournisseur dans la colonne Type et son temps jusqu’au premier token dans la colonne Moy. /24h ; choisissez Modèle IA dans le filtre Type de monitor pour n’afficher qu’eux, avec une colonne Fournisseur · Modèle et le TTFT moyen.
Disponible sur Max (jusqu’à 5 modèles IA) et Enterprise (jusqu’à 20). Un monitor de modèle IA tourne depuis une seule région — ce qui compte, c’est la santé du fournisseur, pas l’accessibilité géographique, et chaque vérification vous coûte de vrais tokens.
Modèles auto-hébergés (agents privés)
Section intitulée « Modèles auto-hébergés (agents privés) »Un modèle servi dans votre propre réseau (Ollama, vLLM, TGI…) n’est joignable
que de l’intérieur. Avec les agents privés,
choisissez Mes agents privés sous Exécuter les checks depuis, puis l’agent
qui y a accès : les adresses internes comme
http://ollama.internal:11434/v1/chat/completions sont acceptées. Le check part
de cet agent unique, comme d’une région pour un fournisseur public.
Paramètres
Section intitulée « Paramètres »| Paramètre | Description | Défaut |
|---|---|---|
| Fournisseur | Compatible OpenAI (OpenAI, Azure, Mistral, Groq, auto-hébergé…), Anthropic, ou AWS Bedrock | Compatible OpenAI |
| URL de l’endpoint à surveiller | L’endpoint de complétion de chat du fournisseur — celui qui accepte un tableau messages, pas une API d’agents ou de conversations | — |
| Clé d’API | Envoyée à chaque check, jamais réaffichée après l’enregistrement. Pour Bedrock : access_key_id:secret_access_key, plus la Région AWS | — |
| Modèle | L’identifiant du modèle à appeler | — |
| Prompt canary | Le prompt fixe envoyé à chaque check | — |
| Région | D’où part le check — une région, ou un agent privé | — |
| Temps max au premier token | Au-delà, en ms, le check est signalé dégradé plutôt que down | 1500 ms |
| Réponse attendue | Optionnel — le check est dégradé si la réponse ne correspond pas exactement (après suppression des espaces de début et de fin) | — |
Fournisseur, endpoint, clé et modèle sont à l’étape Cible ; le prompt, la
limite de TTFT et la réponse attendue sont à l’étape Planification, à côté de
l’intervalle. Si vous fixez une réponse attendue, choisissez un prompt dont la
réponse est courte et déterministe (Réponds par le seul mot OK) : la
comparaison est exacte, ce n’est pas un « contient ».
États de résultat
Section intitulée « États de résultat »Contrairement aux autres types de monitor, qui ne signalent que up ou down, un check de modèle IA distingue quatre états :
- Up — A répondu dans les temps, avec la réponse attendue si vous en avez fixé une.
- Dégradé — A répondu, mais l’assertion de qualité a échoué ou le TTFT maximal est dépassé (le fournisseur est en ligne, mais pas au niveau attendu).
- Ratelimit — A reçu un 429 isolé du fournisseur — traité à part d’une vraie panne, pour qu’une rafale de limitation de débit ne vous réveille pas comme si le fournisseur était tombé.
- Down — Aucune réponse exploitable (délai dépassé, erreur de connexion, 5xx).
Cas d’usage
Section intitulée « Cas d’usage »- Détecter les régressions de qualité silencieuses — Une mise à jour de modèle chez le fournisseur ou un changement de configuration en amont peut laisser l’endpoint techniquement « up » alors que les réponses se dégradent ; l’assertion de contenu l’attrape.
- Suivre la dérive de latence — Le TTFT est souvent le premier signe de problèmes de capacité chez le fournisseur, bien avant les échecs francs.
- Distinguer limitation de débit et panne — Évitez les fausses alertes quand vous atteignez simplement votre propre quota.
Métriques collectées
Section intitulée « Métriques collectées »Chaque check enregistre l’état du résultat, le temps de génération, le temps jusqu’au premier token (TTFT), le temps par token de sortie (TPOT), la latence inter-tokens (ITL) et le résultat de l’assertion de contenu — et alimente les mêmes graphiques et rapports PDF que les autres types de monitor. Chaque métrique est définie dans Métriques & KPIs.