
Prometheus und Grafana
Überblick
Abschnitt betitelt „Überblick“OKStatus stellt den Zustand aller Monitore Ihrer Organisation im Prometheus-Format unter einer einzigen URL bereit:
https://api.okstatus.eu/api/v1/metricsRichten Sie Ihr Prometheus (oder Grafana Alloy, VictoriaMetrics, Grafana Cloud …) darauf aus, und OKStatus wird zu einer weiteren Quelle in Ihrem bestehenden Stack: die Außensicht auf Ihre Dienste, neben Ihren internen Metriken.
Verfügbar ab dem Pro-Tarif.
Einen Metrics-Schlüssel erstellen
Abschnitt betitelt „Einen Metrics-Schlüssel erstellen“- Öffnen Sie Einstellungen → API-Schlüssel.
- In Pro ist der Schlüsseltyp Metrics. In Max und Enterprise wählen Sie unter Zugriff die Option Metrics (vorausgewählt, wenn der Name „prometheus“ oder „grafana“ enthält).
- Benennen Sie den Schlüssel und klicken Sie auf Prometheus-Schlüssel erzeugen.
- Kopieren Sie den Schlüssel: Er wird nur einmal angezeigt.
Ein Metrics-Schlüssel liest /api/v1/metrics und sonst nichts. Gelangt er
aus einer Konfigurationsdatei oder einem Git-Repository nach außen, kann er
weder den Rest der API lesen noch etwas ändern oder löschen. Siehe
API-Schlüssel und Zugriffsstufen.
Prometheus einrichten
Abschnitt betitelt „Prometheus einrichten“Speichern Sie den Schlüssel in einer Datei, die Prometheus lesen kann, nie in
prometheus.yml selbst:
umask 077printf '%s' 'oks_live_…' > /etc/prometheus/okstatus.tokenFügen Sie dann das Ziel hinzu:
scrape_configs: - job_name: okstatus scrape_interval: 30s scheme: https metrics_path: /api/v1/metrics authorization: credentials_file: /etc/prometheus/okstatus.token static_configs: - targets: [api.okstatus.eu]Grafana Alloy:
prometheus.scrape "okstatus" { targets = [{ "__address__" = "api.okstatus.eu" }] scheme = "https" metrics_path = "/api/v1/metrics" scrape_interval = "30s" authorization { credentials_file = "/etc/alloy/okstatus.token" } forward_to = [prometheus.remote_write.default.receiver]}Prometheus Operator (kube-prometheus-stack): Legen Sie den Schlüssel in einem Secret ab, dann:
apiVersion: monitoring.coreos.com/v1alpha1kind: ScrapeConfigmetadata: name: okstatusspec: scheme: HTTPS metricsPath: /api/v1/metrics scrapeInterval: 30s authorization: type: Bearer credentials: name: okstatus-token # Secret with the key under "token" key: token staticConfigs: - targets: [api.okstatus.eu]Prüfen Sie den Schlüssel im Terminal:
curl -s -H "Authorization: Bearer $(cat /etc/prometheus/okstatus.token)" \ https://api.okstatus.eu/api/v1/metrics | grep okstatus_monitor_upIntervall und Limits
Abschnitt betitelt „Intervall und Limits“- Die Antwort wird einmal berechnet und 15 Sekunden pro Organisation zwischengespeichert: Wer öfter als alle 15 s abfragt, erhält dieselben Werte. 30 s oder 60 s sind ein gutes Intervall.
- Jede Organisation kann 60 Mal pro Minute abfragen, in einem eigenen Budget getrennt vom Rest der API (Ihre Terraform-Läufe und Skripte konkurrieren nicht mit Prometheus). Zwei Prometheus-Server im Hochverfügbarkeitsbetrieb passen problemlos hinein.
- Antworten werden gzip-komprimiert, wenn Prometheus danach fragt (was es immer tut).
Grafana-Dashboard
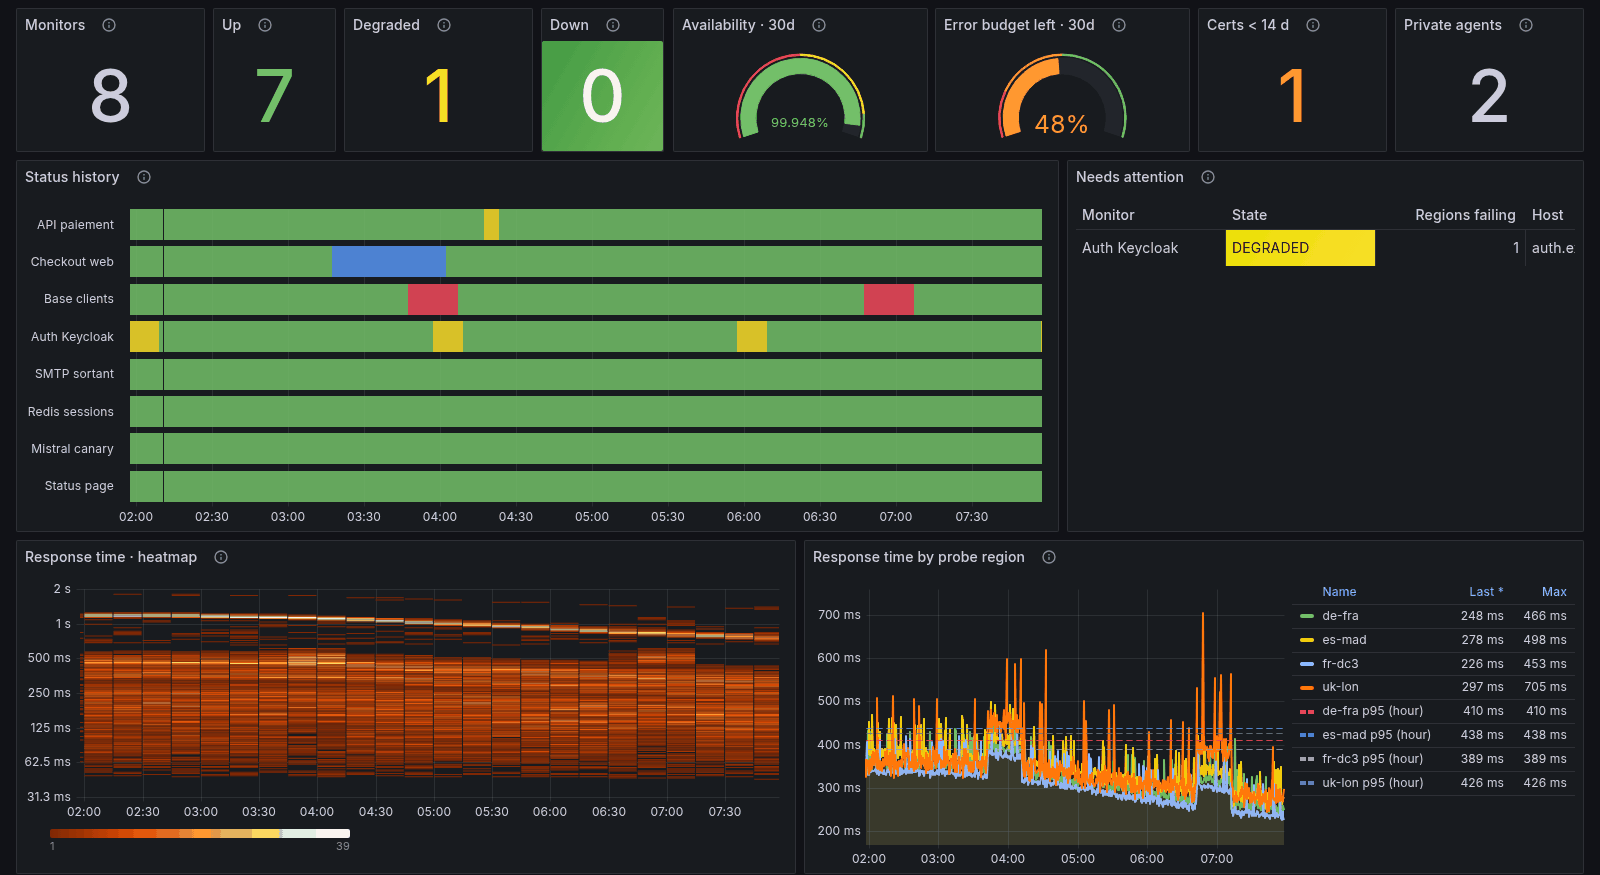
Abschnitt betitelt „Grafana-Dashboard“Das Dashboard OKStatus · Uptime overview nutzt ausschließlich diese Metriken:
- Monitore up, beeinträchtigt und down, mittlere Verfügbarkeit und das verbleibende Fehlerbudget gegenüber Ihrem SLA-Ziel;
- den Statusverlauf jedes Monitors;
- eine Heatmap der Antwortzeiten und die Antwortzeiten je Prüfregion;
- die letzte Prüfung jedes Monitors aus jeder Prüfregion;
- die Verfügbarkeit jedes Monitors im Vergleich zum SLA-Ziel;
- eine Tabelle aller Monitore mit Status, Latenz, Verfügbarkeit über 24 h, 7 Tage und 30 Tage und Tagen bis zum Ablauf des Zertifikats;
- anstehende Abläufe von Zertifikaten und Domains;
- Ihre privaten Agents: Erreichbarkeit, Version und Auslastung;
- eingeklappte Zeilen für KI-Modell-Monitore (Zeit bis zum ersten Token) und SLA-Details je Monitor.
Filter oben: Monitor-Gruppe, Monitor, Prüfregion und SLA-Zeitraum.
Importieren: In Grafana Dashboards → New → Import wählen, die ID 25909 eingeben, auf Load klicken und Ihre Prometheus-Datenquelle auswählen. Das Dashboard ist auf grafana.com veröffentlicht; hat Ihr Grafana keinen Internetzugang, laden Sie stattdessen okstatus-uptime-overview.json hoch. Der Quellcode samt Alarmregeln liegt auf GitHub.
Alarmregeln
Abschnitt betitelt „Alarmregeln“okstatus-alerts.yml enthält zehn fertige Prometheus-Regeln:
| Alarm | Wann |
|---|---|
OKStatusMonitorDown | ein Monitor ist down (Mehrheit seiner Prüfregionen) |
OKStatusMonitorDegraded | seit 10 Minuten beeinträchtigt |
OKStatusProbeRegionDown | eine Prüfregion schlägt seit 15 Minuten fehl, ohne dass der Monitor down ist |
OKStatusCertificateExpiresSoon | ein TLS-Zertifikat läuft in weniger als 14 Tagen ab (kritisch unter 3 Tagen) |
OKStatusDomainExpiresSoon | eine Domain läuft in weniger als 30 Tagen ab |
OKStatusSlaTargetMissed | 30-Tage-Verfügbarkeit unter dem SLA-Ziel des Monitors oder der Organisation |
OKStatusMonitorStale | seit drei Intervallen keine Prüfung, außerhalb von Pause und Wartung |
OKStatusPrivateAgentDown | ein privater Agent sendet keine Lebenszeichen mehr |
OKStatusExportUnreachable | Prometheus kann den Export nicht abfragen (Schlüssel widerrufen oder abgelaufen, Tarif, Netzwerk) |
Laden Sie die Datei mit rule_files: in prometheus.yml oder packen Sie
ihre groups: für den Prometheus Operator in eine PrometheusRule. Setzen
Sie in OKStatusExportUnreachable job auf den Namen Ihres Scrape-Jobs.
Metrik-Referenz
Abschnitt betitelt „Metrik-Referenz“Jede Serie eines Monitors trägt monitor_id, monitor_name,
monitor_type, monitor_host und, wenn der Monitor in einer Gruppe ist,
monitor_group. monitor_host enthält nur den Host (und Port): nie das
Schema, den Pfad, den Query-String oder Zugangsdaten, die Geheimnisse
enthalten können.
| Metrik | Labels | Bedeutung |
|---|---|---|
okstatus_monitor_up | 1 up oder beeinträchtigt, 0 down. Fehlt bei Pause, Wartung, ausstehend oder ohne aktuelle Daten | |
okstatus_monitor_status | state | eine Serie je Zustand (up, degraded, down, paused, maintenance, pending, stale), 1 für den aktuellen |
okstatus_monitor_info | regions | immer 1, trägt die Metadaten des Monitors |
okstatus_monitor_check_interval_seconds | konfiguriertes Prüfintervall | |
okstatus_region_up | probe_region | letzte Prüfung aus dieser Region: 1 up oder beeinträchtigt, 0 down |
okstatus_check_latency_seconds | probe_region | Antwortzeit der letzten Prüfung |
okstatus_check_status_code | probe_region | HTTP-Statuscode der letzten Prüfung |
okstatus_check_timestamp_seconds | probe_region | Zeitpunkt der letzten Prüfung |
okstatus_check_latency_hourly_seconds | probe_region, percentile | p50, p95, p99 der letzten Stundenaggregation (alle Prüfungen, nicht nur abgefragte Werte) |
okstatus_monitor_availability_ratio | window | Verfügbarkeit über 24h, 7d, 30d, 0 bis 1: der Wert aus Dashboard und SLA-Berichten |
okstatus_monitor_downtime_seconds | window | Ausfallzeit im Zeitraum |
okstatus_monitor_sla_target_ratio | SLA-Ziel des Monitors, 0 bis 1 | |
okstatus_org_sla_target_ratio | SLA-Ziel der Organisation, 0 bis 1 | |
okstatus_certificate_expiry_timestamp_seconds | Ablauf des TLS-Zertifikats (tagesgenau) | |
okstatus_domain_expiry_timestamp_seconds | domain | Ablauf der Domain-Registrierung |
okstatus_push_last_received_timestamp_seconds | Heartbeat-Monitore: letzter empfangener Ping | |
okstatus_llm_time_to_first_token_seconds | probe_region | KI-Modell-Monitore: Zeit bis zum ersten Token |
okstatus_llm_time_per_output_token_seconds | probe_region | KI-Modell-Monitore: Zeit je Ausgabe-Token |
okstatus_private_agent_up | agent_id, agent_name | 1, wenn in den letzten 90 Sekunden ein Lebenszeichen kam |
okstatus_private_agent_info | site, version, platform | immer 1 |
okstatus_private_agent_last_heartbeat_timestamp_seconds | agent_id, agent_name | letztes Lebenszeichen |
okstatus_private_agent_active_checks | agent_id, agent_name | gerade laufende Prüfungen |
okstatus_private_agent_max_concurrent_checks | agent_id, agent_name | Parallelitätsgrenze des Agents |
okstatus_exporter_generated_timestamp_seconds | Zeitpunkt, zu dem diese Antwort berechnet wurde | |
okstatus_exporter_info | version | Version des Exporters, immer 1 |
Die Einheiten folgen den Prometheus-Konventionen: Sekunden, Verhältnisse von
0 bis 1, Unix-Zeitstempel. Die Prüfregion heißt probe_region und nicht
region, das viele Prometheus-Installationen bereits als externes Label
verwenden.
Nützliche Abfragen
Abschnitt betitelt „Nützliche Abfragen“# Tage bis zum Ablauf jedes Zertifikats(okstatus_certificate_expiry_timestamp_seconds - time()) / 86400
# Monitore, die gerade down sindokstatus_monitor_up == 0
# Mittlere Antwortzeit je Prüfregionavg by (probe_region) (okstatus_check_latency_seconds)
# Von außen down, während Ihre Blackbox-Probe ihn als up sieht:# ein DNS-, CDN- oder Routing-Problem, nicht der Dienst selbstokstatus_monitor_up == 0 and on (monitor_host) label_replace(probe_success == 1, "monitor_host", "$1", "instance", "https?://([^/]+).*")| Status | Bedeutung |
|---|---|
401 | Schlüssel fehlt, ist ungültig, widerrufen oder abgelaufen |
403 | der Tarif der Organisation enthält den Export nicht, oder der Zugriff des Schlüssels erlaubt ihn nicht |
429 | mehr als 60 Abfragen pro Minute: Diese Abfrage schlägt fehl, das nächste Intervall geht durch |