
KI-Modell
Überblick
Abschnitt betitelt „Überblick“Der KI-Modell-Monitor (ein LLM-Canary) sendet nach Zeitplan einen festen Prompt an den Chat-Completions-Endpunkt eines LLM-Anbieters und prüft, dass er antwortet — und zwar korrekt und innerhalb akzeptabler Zeit. Er ist für Teams gebaut, die produktive Funktionen auf einer LLM-API betreiben und in dem Moment Bescheid wissen müssen, in dem diese Abhängigkeit schwächelt, nicht erst, wenn sie ganz ausfällt.
Angelegt wird er unter Monitore → Monitor hinzufügen, indem Sie in der Typliste KI-Modell wählen: Der Dialog fragt dann Anbieter, Endpunkt, API-Schlüssel und Modell ab statt der HTTP-Optionen. In der Monitor-Liste zeigt ein KI-Modell das Logo seines Anbieters in der Spalte Typ und seine Zeit bis zum ersten Token in der Spalte Ø /24h; wählen Sie KI-Modell im Filter Monitor-Typ, um nur diese zu sehen, mit einer Spalte Anbieter · Modell und der durchschnittlichen TTFT.
Verfügbar in Max (bis zu 5 KI-Modelle) und Enterprise (bis zu 20). Ein KI-Modell-Monitor läuft aus einer einzigen Region — es geht um die Gesundheit des Anbieters, nicht um geografische Erreichbarkeit, und jede Prüfung kostet Sie echte Tokens.
Selbst gehostete Modelle (private Agents)
Abschnitt betitelt „Selbst gehostete Modelle (private Agents)“Ein Modell, das in Ihrem eigenen Netz läuft (Ollama, vLLM, TGI …), ist nur von
dort erreichbar. Mit privaten Agents wählen Sie
unter Checks ausführen von die Option Meine privaten Agents und dann den
Agent, der es erreicht: Interne Adressen wie
http://ollama.internal:11434/v1/chat/completions sind erlaubt. Der Check läuft
von diesem einen Agent aus, so wie von einer Region bei einem öffentlichen
Anbieter.
Einstellungen
Abschnitt betitelt „Einstellungen“| Einstellung | Beschreibung | Standard |
|---|---|---|
| Anbieter | openai-compatible, anthropic oder bedrock | openai-compatible |
| Endpunkt-URL | Der Chat-Completions-Endpunkt des Anbieters | — |
| API-Schlüssel | Zugangsdatum zur Authentifizierung der Anfrage | — |
| Modell | Die aufzurufende Modellkennung | — |
| Prompt | Der feste Prompt, der bei jeder Prüfung gesendet wird | — |
| Region | Von wo aus die Prüfung läuft | — |
| Max. TTFT | Maximal akzeptable Zeit bis zum ersten Token, in ms, bevor die Prüfung als beeinträchtigt gilt | 1500 ms |
| Erwarteter Inhalt | Text, den die Antwort enthalten muss, damit die Qualitätszusicherung besteht | — |
Ergebniszustände
Abschnitt betitelt „Ergebniszustände“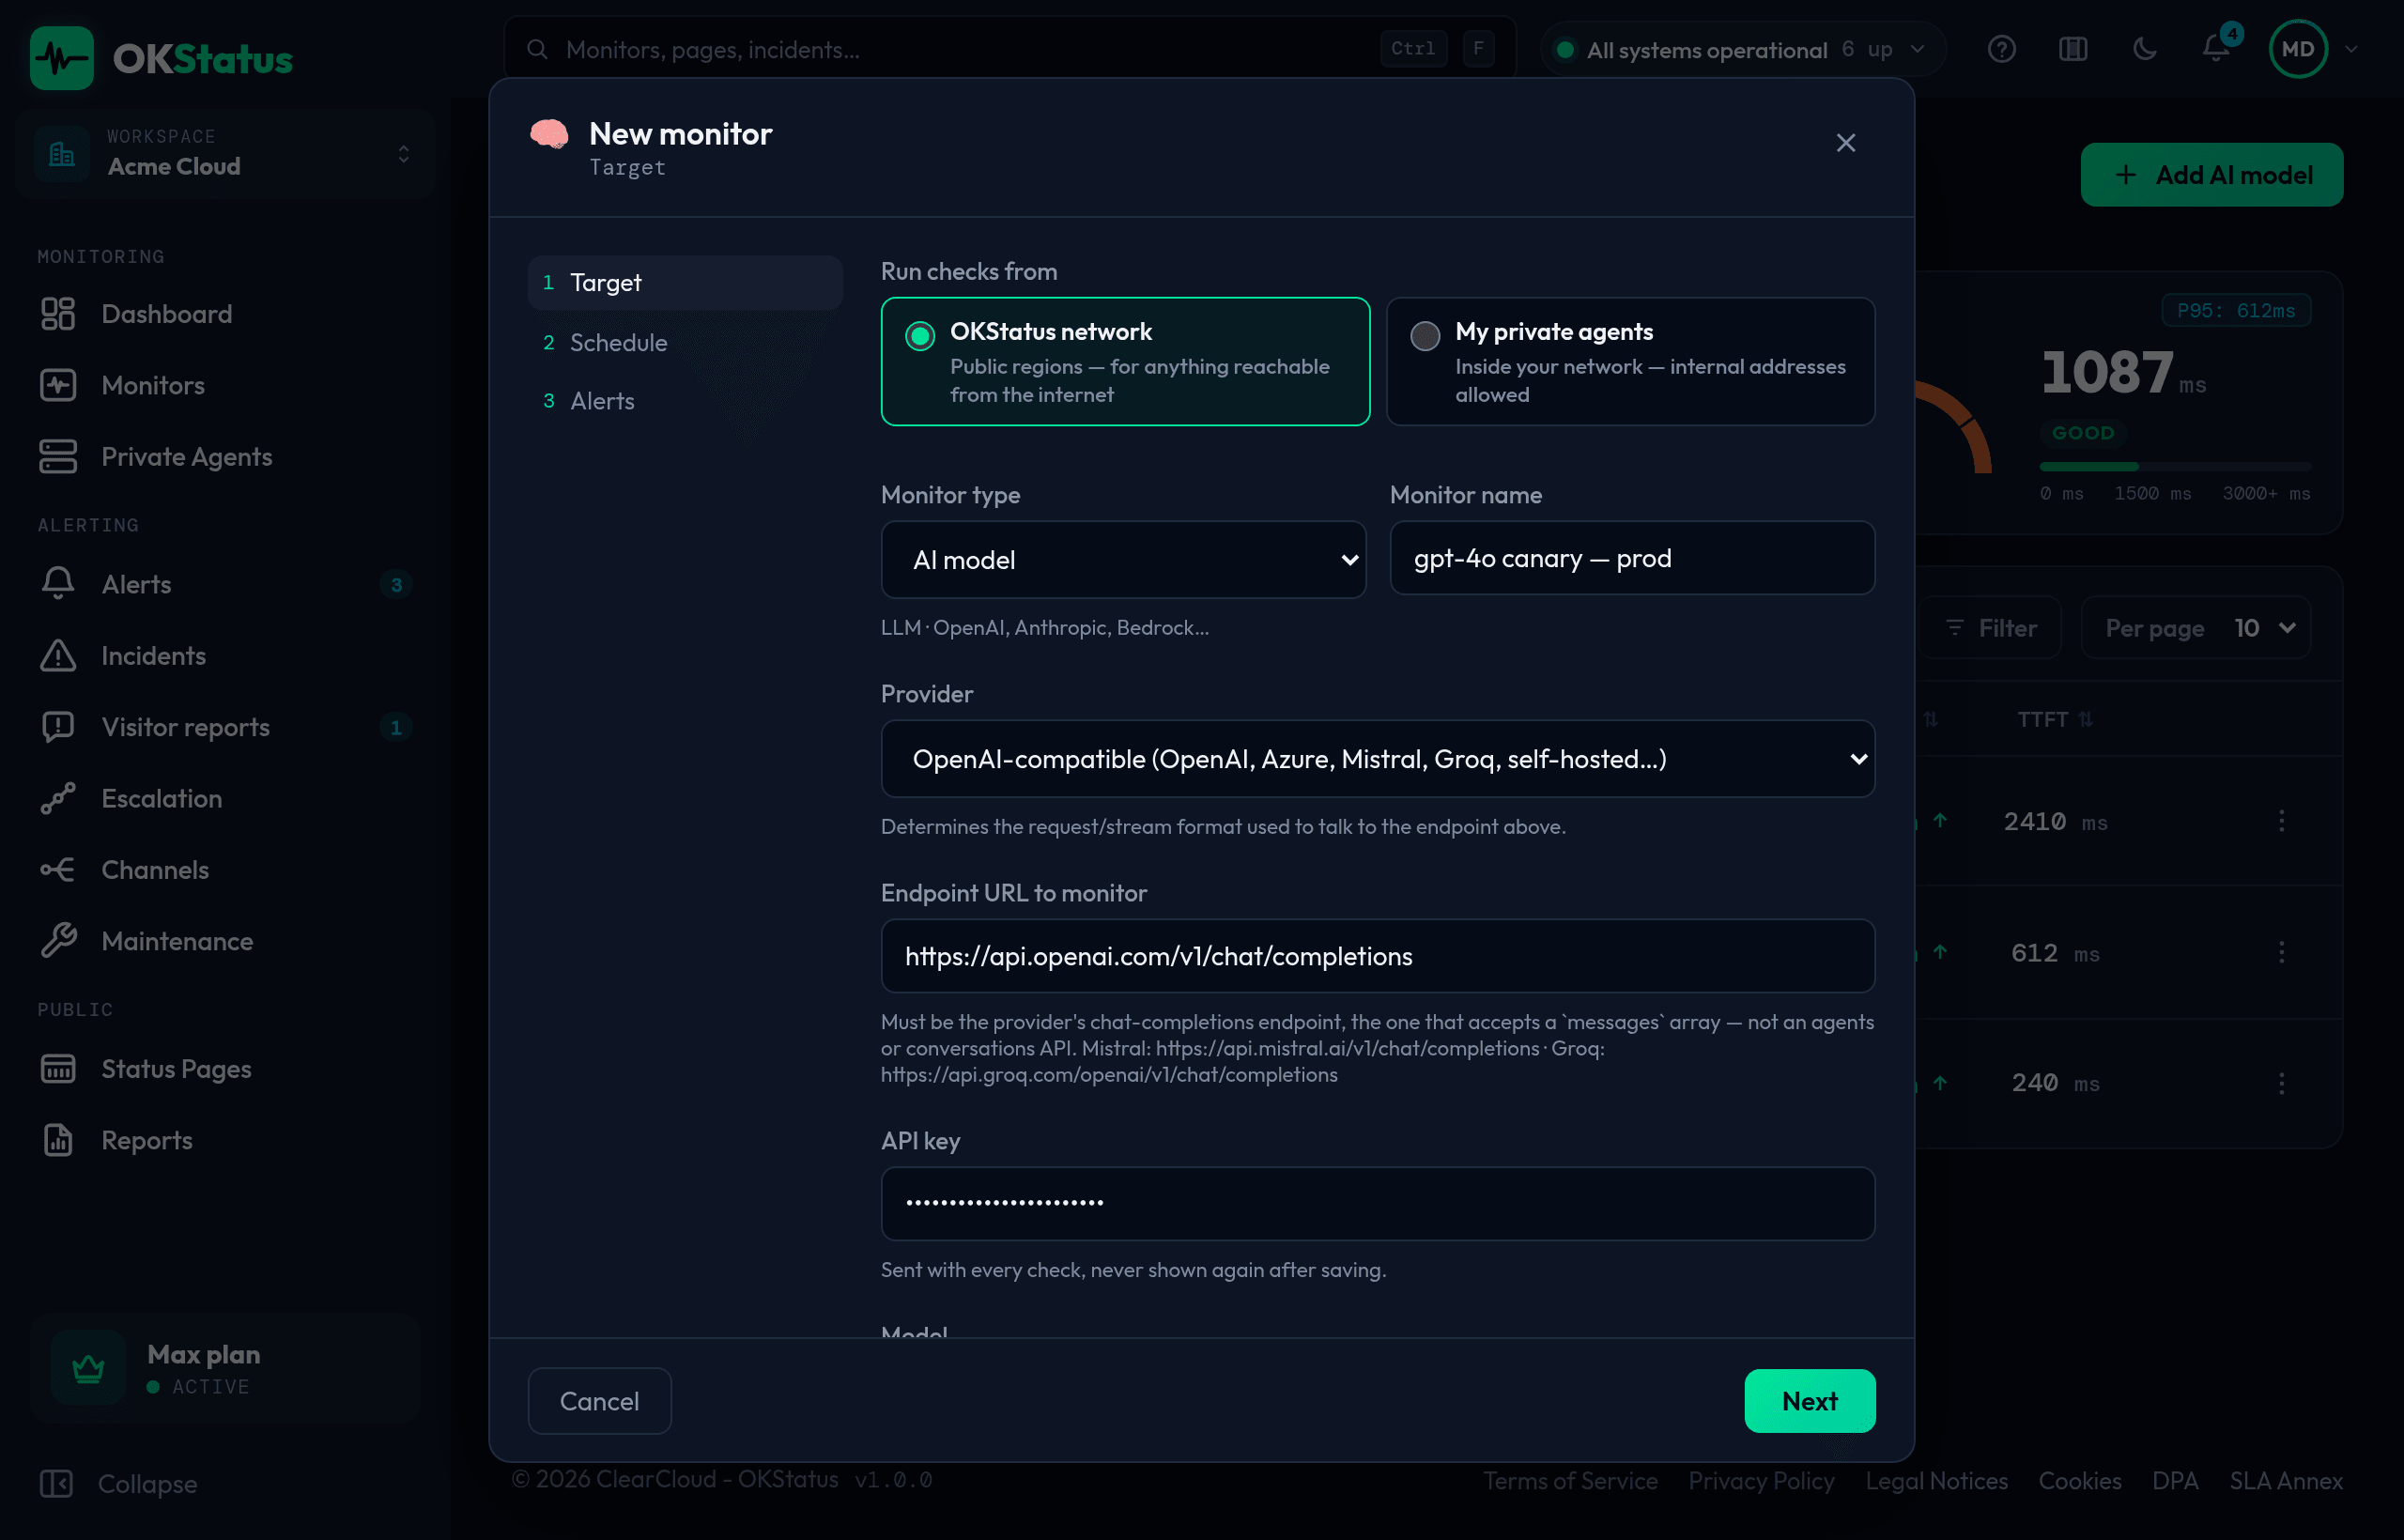
Anders als andere Monitor-Typen, die nur up oder down melden, unterscheiden KI-Modell-Prüfungen vier Zustände:
- Up — Rechtzeitig geantwortet, mit Inhalt, der zur Zusicherung passt.
- Beeinträchtigt — Geantwortet, aber die Qualitätszusicherung verfehlt oder die maximale TTFT überschritten (der Anbieter läuft, erfüllt aber nicht die Vorgabe).
- Ratelimit — Eine vereinzelte 429 vom Anbieter erhalten — getrennt von einem echten Ausfall behandelt, damit ein Schwall Ratenbegrenzung Sie nicht weckt, als wäre der Anbieter ausgefallen.
- Down — Überhaupt keine brauchbare Antwort (Zeitüberschreitung, Verbindungsfehler, 5xx).
Anwendungsfälle
Abschnitt betitelt „Anwendungsfälle“- Stille Qualitätsrückschritte erkennen — Ein Modell-Update beim Anbieter oder eine Konfigurationsänderung stromaufwärts kann den Endpunkt technisch „up” lassen, während die Antworten schlechter werden; die Inhaltszusicherung fängt das ab.
- Latenzdrift verfolgen — Die TTFT ist oft das erste Anzeichen von Kapazitätsproblemen beim Anbieter, lange vor echten Fehlschlägen.
- Ratenbegrenzung von Ausfällen unterscheiden — Fehlalarme vermeiden, wenn Sie schlicht Ihr eigenes Kontingent ausschöpfen.
Erfasste Messwerte
Abschnitt betitelt „Erfasste Messwerte“Jede Prüfung erfasst den Ergebniszustand, die Antwortlatenz, die Zeit bis zum ersten Token (TTFT) und ob die Inhaltszusicherung bestanden wurde — und speist damit dieselben Diagramme und PDF-Berichte wie jeder andere Monitor-Typ.